Recherche
Organiser une base de données de recherche
Du fichier brut à la base versionnée : socles par pathologie, index pseudonymisé, contrôles qualité, et une page de requête qui ne montre que des agrégats.
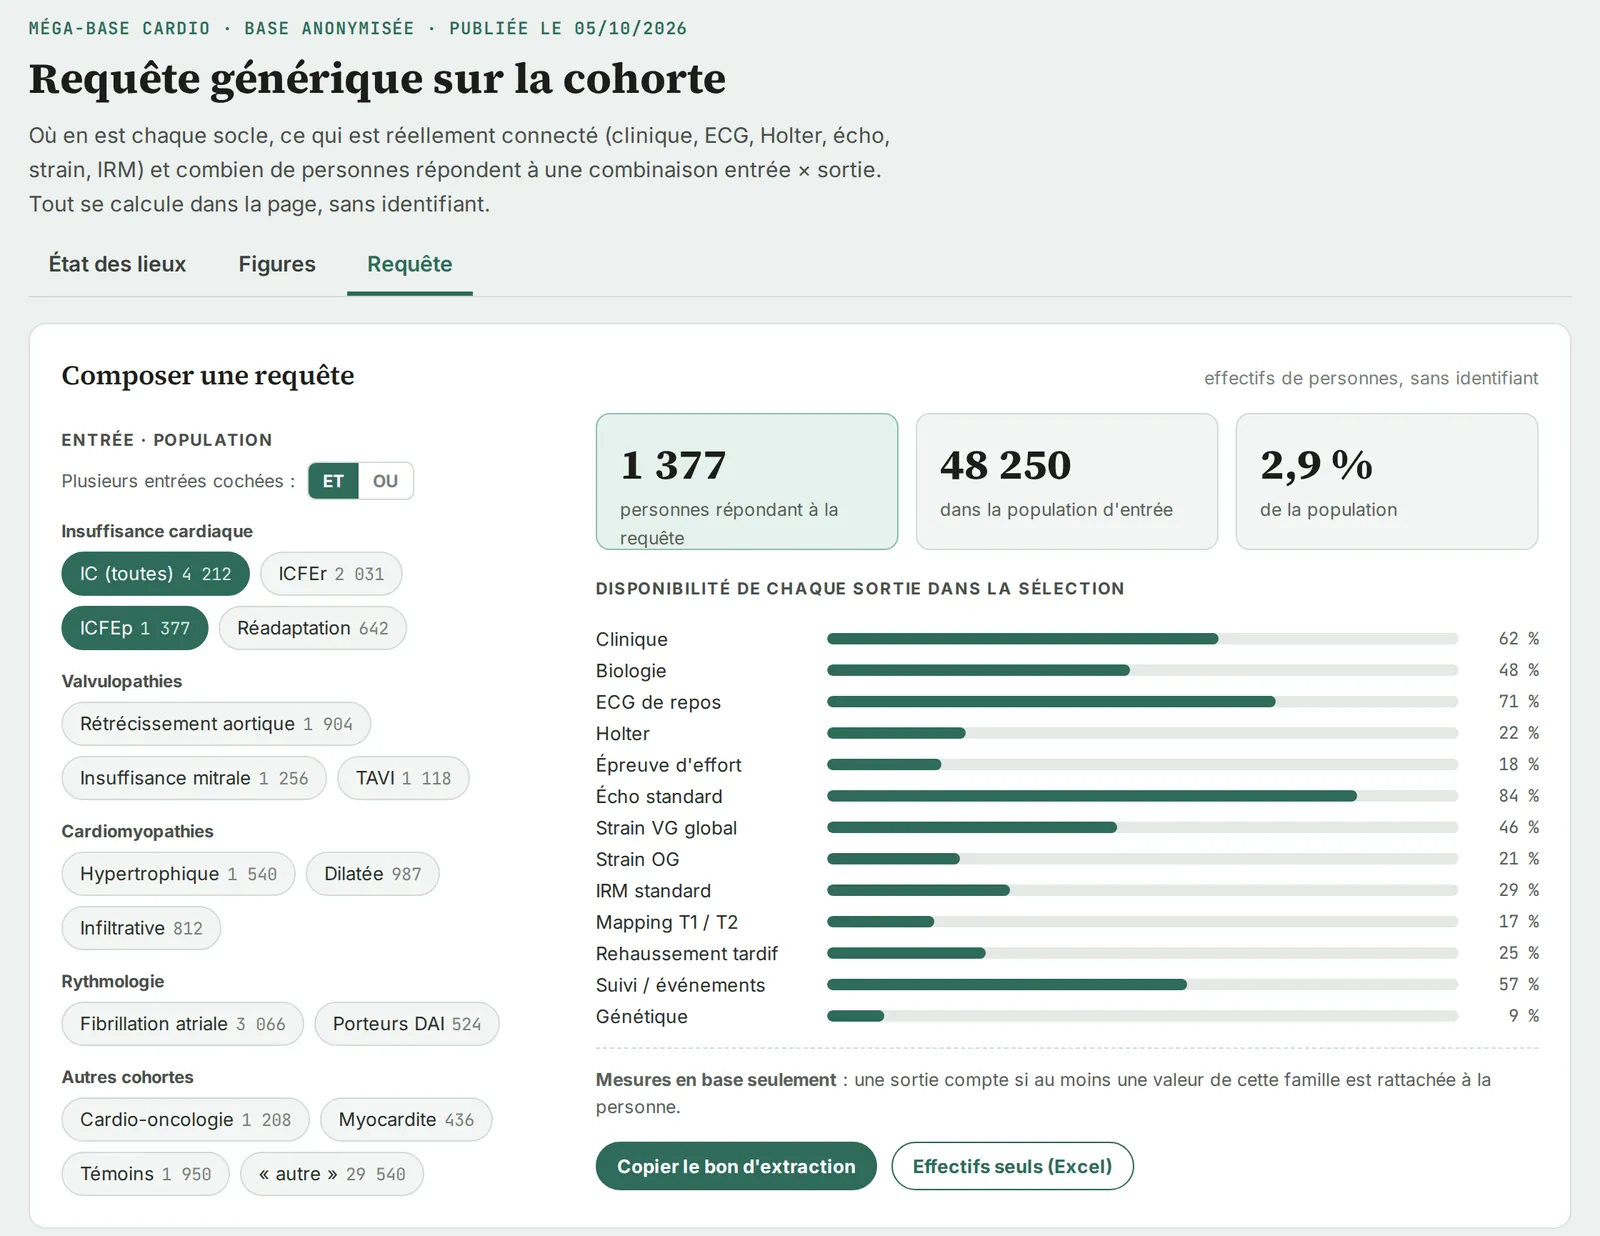
Capture d’un outil réel · données fictives, noms floutés
Le problème
Des années de tableurs de cohortes, d’exports d’examens et de recueils de thèses, chacun dans son format. La question « combien de patients avons-nous avec tel phénotype et telle donnée ? » prend une semaine.
La méthode pas à pas
-
Un pipeline écrit : original → brut → harmonisé → base → analyse → export, chaque étape dans son dossier, rien n’est modifié en place. La base est copiée en local, jamais ouverte sur un dossier réseau ; les longs traitements sont reprenables, chaque écriture se fait en tout ou rien avec recomptage, et une version est publiée par copie vérifiée puis bascule, l’ancienne étant archivée.
-
Des socles par pathologie, chacun avec sa version (candidate, gelée) et une procédure de gel. Le gel suit cinq étapes : un cahier de variables pré-rempli (type déduit, taux de remplissage réel) validé par le responsable, l’import, un rapport qualité en cinq familles (identité, doublons, plages, cohérence, complétude), l’arbitrage des écarts en bloc, puis un gel numéroté et horodaté avec sa copie figée. Une variable sans décision n’est pas retenue ; une correction de fond ouvre une nouvelle version et refait les cinq étapes.
-
Un index pivot pseudonymisé pour dédoublonner les patients présents dans plusieurs cohortes, conservé sur le poste. Le rapprochement entre sources repose sur un score, jamais sur un seul paramètre : voir Rapprocher des patients sans les fusionner à tort.
-
Des règles de contrôle qualité et un journal des décisions (pourquoi telle variable a été recodée). Les données sont tenues en format long, chaque valeur tracée jusqu’à sa cellule d’origine (fichier, feuille, ligne, colonne). Une valeur invalide, une unité incertaine ou un conflit entre sources est conservé et étiqueté ; au gel, une seule valeur de référence est retenue. NULL n’est pas zéro, et toute exclusion est motivée et réversible.
-
Distinguer « mesure en base » et « fichier disponible » : on sait ce qui est réellement exploitable. On publie trois niveaux de chiffres : personnes recensées, personnes avec un fichier source, personnes avec des mesures en base, plus la complétude maximale d’une mesure en croisant tous les fichiers. Un audit de couverture, année par année, sépare un trou de la source (examens seulement datés, confirmés par un ré-export identique) d’un échec de liaison, avec un recomptage indépendant.
-
Une page de requête qui ne manipule que des agrégats : population, critères, données requises, résultat en effectifs. Chaque panneau statistique porte un encadré « limites » : phénotype défini par paliers, couple de deux examens formé dans une fenêtre de temps et sur des liens fiables seulement, médiane [Q1–Q3] avec le nombre de mesures, et tout effectif sous le seuil convenu affiché « moins de N ».
-
L’extraction nominative se fait en local, par un script, sur la base d’un « bon d’extraction » validé. Le bon produit un classeur normalisé (onglets LISEZ_MOI, PATIENTS, un par famille de données, DICTIONNAIRE, SOURCES), pseudonymisé par défaut ; le bouton « effectifs seuls » suffit souvent. Chaque requête est journalisée (date, spécification) pour pouvoir être rejouée à l’identique.
-
Un « tiroir » pour les données sensibles : ce qui ne doit jamais entrer dans les outils d’IA est isolé, documenté, et les questions ouvertes sur son accès sont tranchées avec l’établissement. Concrètement, deux copies : la base de travail pseudonymisée (identifiants aléatoires, année de naissance seule, texte libre nettoyé, équivalence avec l’original prouvée, version numérotée) et le coffre (clé de correspondance et originaux). L’IA ne travaille que sur la base pseudonymisée ; le coffre n’est ouvert que sur demande explicite, pour rapprocher des identités ou produire un livrable nominatif demandé, qui reste sur le poste.
-
Exports pour les collaborateurs : figures et tableaux agrégés, jamais de données individuelles.
-
Une check-list pour chaque nouvelle source : comment elle identifie un patient (numéro d’inclusion dont le préfixe code le centre, code d’initiales, code opaque, numéro seul ; une valeur collective n’est jamais transformée en patient), quelles feuilles sont des dictionnaires ou des tableaux transposés (sources de faux patients), et une architecture à deux étages : l’inclusion d’abord, puis l’enrichissement, qui n’ajoute jamais de patient (vérifié à chaque import). On repart du script de la cohorte la plus proche.
Aller plus loin
- Un contrôle qualité sans fausses alertes : des plages physiologiques écrites ; des unités mélangées soupçonnées seulement avec au moins deux fichiers sources et un regroupement net par facteur 10 ; jamais d’alerte sur un identifiant ni de plage sur une variable 0/1 ; une convention de signe qui change selon l’année ramenée à la valeur absolue.
- Les données tirées du compte rendu : une valeur absente du tableau est cherchée dans le compte rendu, qui fait foi ; la négation est bornée à la ligne ; une indication d’examen n’est pas un diagnostic ; l’extrait justificatif est gardé et l’origine étiquetée (tableau, compte rendu, qualitatif, absent).
- Toute liste de patients déclenche une requête longitudinale : appariement sur au moins deux éléments d’identité ; par personne, nombre d’examens, première et dernière date, durée de suivi ; trois fichiers en sortie (nominatif sur le poste, pseudonymisé, effectifs agrégés pour la conversation). Les absents de l’index attendent dans un module (rattaché, nouveau, douteux), fusionné à la version suivante.
- Une sentinelle hebdomadaire en lecture seule : intégrité, orphelins, doublons, plages, complétude par année, fichiers nouveaux, modifiés ou chiffrés ; verdict OK, alerte ou erreur, comparé à celui de la semaine précédente.
- Fiches et cas liés : Rapprocher des patients sans les fusionner à tort, Préparer la saisie d’un registre, Construire une base de recherche avec Claude.
Le livrable
Une base versionnée, documentée, et une réponse en minutes à « combien de patients pour cette étude ? ».
Garde-fous
Les autorisations d’abord : base légale, accord du délégué à la protection des données et de la recherche clinique, endroit où le traitement par IA est autorisé, et personne qui décide des gels. Données de santé : cadre réglementaire applicable à la recherche (déclaration, méthodologie de référence, information des patients), stockage autorisé par l’établissement, aucune donnée identifiante dans un service non autorisé. Consultez la délégation à la recherche clinique et le DPO de votre établissement.
Prompt de départ
Voici la liste (noms de colonnes uniquement, sans données) de mes 4 fichiers de cohorte. Propose un dictionnaire de variables harmonisé, les règles de contrôle qualité, et l’arborescence du pipeline. N’ouvre aucune donnée patient.