Forschung
Eine Forschungsdatenbank organisieren
Von der Rohdatei zur versionierten Datenbank: krankheitsspezifische Kerndatensätze, ein pseudonymisierter Index, Qualitätskontrollen und eine Abfrageseite, die nur aggregierte Werte zeigt.
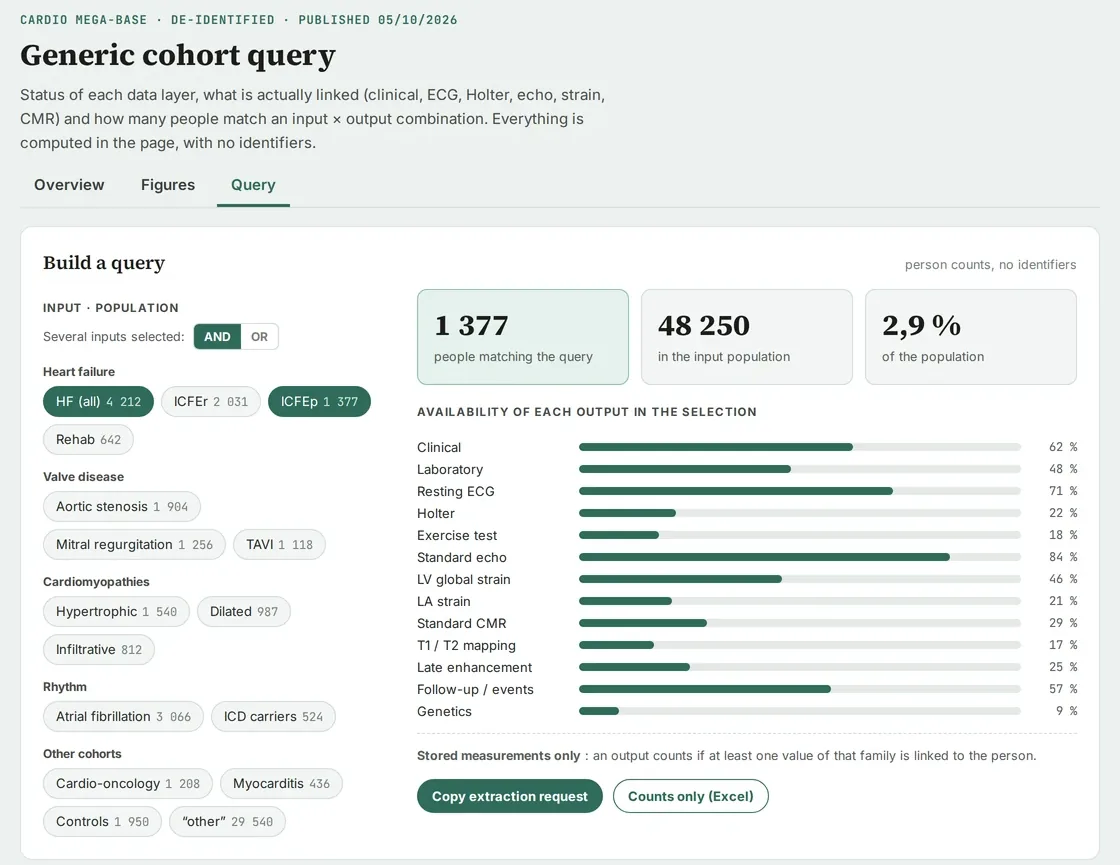
Bildschirmfoto eines echten Werkzeugs · fiktive Daten, Namen unkenntlich · Oberfläche auf Englisch
Das Problem
Jahre an Kohorten-Tabellen, Untersuchungsexporten und Datenerhebungen aus Doktorarbeiten, jede in ihrem eigenen Format. Die Frage „Wie viele Patienten haben wir mit diesem Phänotyp und diesem Datenelement?“ dauert eine Woche.
Schritt für Schritt
-
Eine schriftlich festgelegte Pipeline: Original → Rohdaten → harmonisiert → Datenbank → Analyse → Export, jede Stufe in einem eigenen Ordner; nichts wird an Ort und Stelle verändert. Die Datenbank wird lokal kopiert und nie auf einem Netzlaufwerk geöffnet; lange Verarbeitungen lassen sich fortsetzen, jeder Schreibvorgang erfolgt nach dem Alles-oder-nichts-Prinzip mit Nachzählung, und eine Version wird per geprüfter Kopie und anschließender Umschaltung veröffentlicht, die alte wird archiviert.
-
Kerndatensätze pro Krankheit, jeweils mit Version (Kandidat, eingefroren) und einem Verfahren zum Einfrieren. Das Einfrieren folgt fünf Schritten: ein vorausgefülltes Variablenheft (abgeleiteter Typ, tatsächliche Ausfüllrate), von der verantwortlichen Person freigegeben, der Import, ein Qualitätsbericht in fünf Gruppen (Identität, Dubletten, Wertebereiche, Konsistenz, Vollständigkeit), die gebündelte Entscheidung über Abweichungen und schließlich ein nummerierter Stand mit Zeitstempel und eingefrorener Kopie. Eine Variable ohne Entscheidung wird nicht übernommen; eine inhaltliche Korrektur eröffnet eine neue Version und durchläuft die fünf Schritte erneut.
-
Ein pseudonymisierter Pivot-Index, um Patienten zu deduplizieren, die in mehreren Kohorten vorkommen, gespeichert auf dem lokalen Arbeitsplatzrechner. Die Zuordnung zwischen Quellen beruht auf einem Score, nie auf einem einzelnen Merkmal: siehe Patienten zusammenführen, ohne sie fälschlich zu verschmelzen.
-
Regeln zur Qualitätskontrolle und ein Entscheidungsprotokoll (warum eine bestimmte Variable umkodiert wurde). Die Daten werden im Langformat geführt, jeder Wert bis zu seiner Ursprungszelle zurückverfolgbar (Datei, Blatt, Zeile, Spalte). Ein ungültiger Wert, eine unsichere Einheit oder ein Widerspruch zwischen Quellen bleibt erhalten und wird gekennzeichnet; beim Einfrieren wird ein einziger Referenzwert festgelegt. NULL ist nicht null, und jeder Ausschluss ist begründet und umkehrbar.
-
„Messwert in der Datenbank“ von „Datei vorhanden“ unterscheiden: So wissen Sie, was tatsächlich nutzbar ist. Berichtet werden drei Ebenen von Zahlen: erfasste Personen, Personen mit einer Quelldatei, Personen mit Messwerten in der Datenbank, dazu die maximal erreichbare Vollständigkeit eines Messwerts über alle Dateien hinweg. Ein Abdeckungsaudit Jahr für Jahr unterscheidet eine Lücke der Quelle (Untersuchungen nur mit Datum, bestätigt durch einen identischen Neuexport) von einem gescheiterten Abgleich, mit einer unabhängigen Nachzählung.
-
Eine Abfrageseite, die nur mit aggregierten Werten arbeitet: Population, Kriterien, benötigte Daten, Ergebnis als Fallzahlen. Jedes Statistikfeld trägt einen Kasten „Grenzen“: Phänotyp in Stufen definiert, Paare aus zwei Untersuchungen nur innerhalb eines Zeitfensters und über verlässliche Verknüpfungen, Median [Q1–Q3] mit Anzahl der Messwerte, und jede Fallzahl unter der vereinbarten Schwelle als „weniger als N“ angezeigt.
-
Identifizierende Extraktion erfolgt lokal, per Skript, auf Grundlage einer freigegebenen „Extraktionsanfrage“. Der Auftrag erzeugt eine normierte Arbeitsmappe (Blätter LIESMICH, PATIENTEN, eines je Datengruppe, WÖRTERBUCH, QUELLEN), standardmäßig pseudonymisiert; oft genügt die Schaltfläche „nur Fallzahlen“. Jede Abfrage wird protokolliert (Datum, Spezifikation), damit sie sich identisch wiederholen lässt.
-
Eine „verschlossene Schublade“ für sensible Daten: Was niemals in KI-Werkzeuge gelangen darf, wird isoliert und dokumentiert; offene Fragen zum Zugriff darauf werden mit der Einrichtung geklärt. Konkret zwei Kopien: die pseudonymisierte Arbeitsdatenbank (zufällige Kennungen, nur Geburtsjahr, bereinigter Freitext, nachgewiesene Gleichwertigkeit mit dem Original, nummerierte Version) und der Tresor (Zuordnungsschlüssel und Originale). Die KI arbeitet nur mit der pseudonymisierten Datenbank; der Tresor wird nur auf ausdrückliche Anfrage geöffnet, um Identitäten abzugleichen oder ein angefordertes personenbezogenes Ergebnis zu erstellen, das auf dem Arbeitsplatzrechner bleibt.
-
Exporte für Kooperationspartner: aggregierte Zahlen und Tabellen, niemals Daten auf Einzelpersonenebene.
-
Eine Checkliste für jede neue Quelle: wie sie einen Patienten identifiziert (Einschlussnummer, deren Präfix das Zentrum kodiert, Initialen-Code, undurchsichtiger Code, reine Nummer; ein Sammelwert wird nie zu einem Patienten), welche Blätter Wörterbücher oder transponierte Tabellen sind (Quelle von Scheinpatienten), und eine zweistufige Architektur: zuerst der Einschluss, dann die Anreicherung, die nie einen Patienten hinzufügt (bei jedem Import geprüft). Ausgangspunkt ist das Skript der ähnlichsten Kohorte.
Weiterführend
- Qualitätskontrolle ohne Fehlalarme: schriftlich festgelegte physiologische Wertebereiche; gemischte Einheiten nur bei mindestens zwei Quelldateien und einer deutlichen Häufung um den Faktor 10 vermutet; nie ein Alarm auf einer Kennung und keine Bereichsprüfung bei einer 0/1-Variablen; eine je nach Jahr wechselnde Vorzeichenkonvention wird auf den Betrag zurückgeführt.
- Daten aus dem Befundbericht: Ein in der Tabelle fehlender Wert wird im Befund gesucht, der maßgeblich ist; eine Verneinung gilt nur für ihre Zeile; eine Untersuchungsindikation ist keine Diagnose; der belegende Auszug wird aufbewahrt und die Herkunft gekennzeichnet (Tabelle, Befund, qualitativ, fehlend).
- Jede Patientenliste löst eine Längsschnittabfrage aus: Abgleich über mindestens zwei Identitätsmerkmale; je Person Anzahl der Untersuchungen, erstes und letztes Datum, Nachbeobachtungsdauer; drei Ausgabedateien (personenbezogen auf dem Arbeitsplatzrechner, pseudonymisiert, aggregierte Fallzahlen für die Unterhaltung). Wer im Index fehlt, wartet in einem Wartemodul (zugeordnet, neu, zweifelhaft), das in die nächste Version einfließt.
- Ein wöchentlicher Wächter, nur lesend: Integrität, verwaiste Datensätze, Dubletten, Wertebereiche, Vollständigkeit pro Jahr, neue, geänderte oder verschlüsselte Dateien; Urteil OK, Warnung oder Fehler, verglichen mit dem der Vorwoche.
- Verwandte Leitfäden und Fallbeispiel: Patienten zusammenführen, ohne sie fälschlich zu verschmelzen, Die Dateneingabe für ein Register vorbereiten, Mit Claude eine Forschungsdatenbank aufbauen.
Ergebnis
Eine versionierte, dokumentierte Datenbank und eine Antwort in wenigen Minuten auf die Frage „Wie viele Patienten für diese Studie?“.
Schutzvorkehrungen
Zuerst die Genehmigungen: Rechtsgrundlage, Zustimmung des Datenschutzbeauftragten und der Abteilung für klinische Forschung, Ort, an dem die Verarbeitung mit KI zugelassen ist, und wer über das Einfrieren entscheidet. Gesundheitsdaten: der für die Forschung geltende Rechtsrahmen (Meldung, Referenzmethodik, Patienteninformation), von der Einrichtung zugelassene Speicherung, keine identifizierenden Daten in einem nicht zugelassenen Dienst. Wenden Sie sich an die Abteilung für klinische Forschung Ihrer Einrichtung und an den Datenschutzbeauftragten.
Einstiegsprompt
Hier ist die Liste (nur Spaltennamen, keine Daten) meiner 4 Kohortendateien. Schlage ein harmonisiertes Datenwörterbuch, Regeln zur Qualitätskontrolle und die Ordnerstruktur der Pipeline vor. Öffne keine Patientendaten.