Ricerca
Organizzare un database di ricerca
Dal file grezzo al database versionato: dataset di base per patologia, un indice pseudonimizzato, controlli di qualità e una pagina di interrogazione che mostra solo dati aggregati.
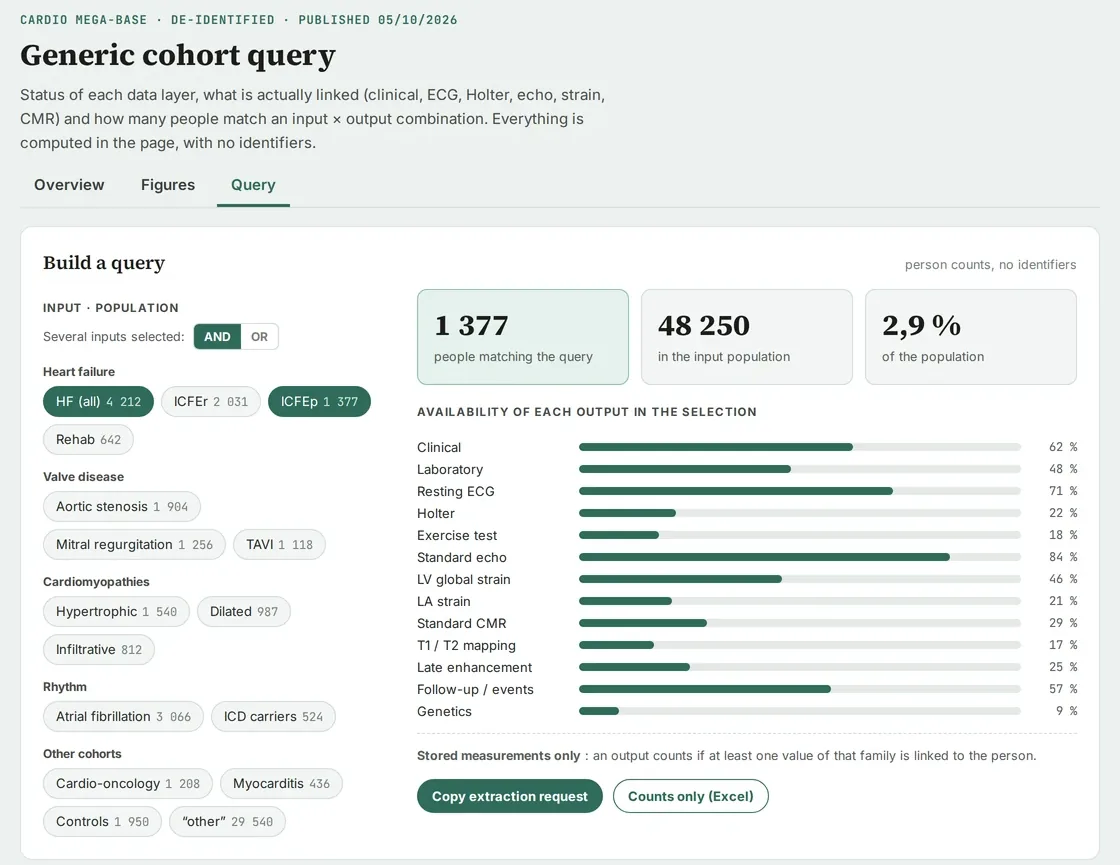
Schermata di uno strumento reale · dati fittizi, nomi sfocati · interfaccia in inglese
Il problema
Anni di fogli di calcolo di coorti, esportazioni di esami e raccolte dati di tesi, ciascuno nel proprio formato. La domanda «quanti pazienti abbiamo con questo fenotipo e questo dato?» richiede una settimana.
Metodo passo per passo
-
Una pipeline scritta: originale → grezzo → armonizzato → database → analisi → esportazione, ogni fase nella propria cartella; nulla viene modificato sul posto. Il database viene copiato in locale, mai aperto su una cartella di rete; le elaborazioni lunghe possono essere riprese, ogni scrittura avviene in modalità tutto o niente con riconteggio, e una versione viene pubblicata tramite copia verificata e poi sostituzione, archiviando la precedente.
-
Dataset di base per patologia, ciascuno con la sua versione (candidata, congelata) e una procedura di congelamento. Il congelamento segue cinque fasi: un quaderno delle variabili precompilato (tipo dedotto, tasso di compilazione reale) convalidato dal responsabile, l’importazione, un rapporto di qualità in cinque famiglie (identità, doppioni, intervalli, coerenza, completezza), la decisione sulle discrepanze in blocco, poi un congelamento numerato e datato con la sua copia bloccata. Una variabile senza decisione non viene mantenuta; una correzione sostanziale apre una nuova versione e ripete le cinque fasi.
-
Un indice pivot pseudonimizzato per eliminare i doppioni dei pazienti presenti in più coorti, conservato sulla postazione locale. L’abbinamento tra fonti si basa su un punteggio, mai su un solo parametro: vedi Abbinare i pazienti senza fonderli per errore.
-
Regole di controllo qualità e un registro delle decisioni (perché una certa variabile è stata ricodificata). I dati sono tenuti in formato lungo, ogni valore tracciato fino alla cella di origine (file, foglio, riga, colonna). Un valore non valido, un’unità incerta o un conflitto tra fonti viene conservato ed etichettato; al congelamento si sceglie un solo valore di riferimento. NULL non è zero, e ogni esclusione è motivata e reversibile.
-
Distinguere «misura presente nel database» da «file disponibile»: si sa che cosa è davvero utilizzabile. Si riportano tre livelli di cifre: persone censite, persone con un file sorgente, persone con misure nel database, più la completezza massima di una misura incrociando tutti i file. Un audit di copertura anno per anno distingue un vuoto della fonte (esami soltanto datati, confermati da una riesportazione identica) da un mancato collegamento, con un riconteggio indipendente.
-
Una pagina di interrogazione che gestisce solo dati aggregati: popolazione, criteri, dati richiesti, risultato sotto forma di conteggi. Ogni pannello statistico ha un riquadro «limiti»: fenotipo definito per livelli, coppia di due esami formata entro una finestra temporale e solo su collegamenti affidabili, mediana [Q1–Q3] con il numero di misure, e ogni conteggio sotto la soglia concordata mostrato come «meno di N».
-
L’estrazione di dati identificativi avviene in locale, tramite uno script, sulla base di una «richiesta di estrazione» convalidata. La richiesta produce una cartella di lavoro normalizzata (schede LEGGIMI, PAZIENTI, una per famiglia di dati, DIZIONARIO, FONTI), pseudonimizzata per impostazione predefinita; il pulsante «solo conteggi» spesso basta. Ogni interrogazione viene registrata (data, specifica) per poter essere ripetuta in modo identico.
-
Un «cassetto chiuso a chiave» per i dati sensibili: ciò che non deve mai entrare negli strumenti di IA viene isolato e documentato, e le questioni aperte sull’accesso vengono risolte con l’istituzione. In concreto, due copie: il database di lavoro pseudonimizzato (identificativi casuali, solo anno di nascita, testo libero ripulito, equivalenza con l’originale dimostrata, versione numerata) e la cassaforte (chiave di corrispondenza e originali). L’IA lavora solo sul database pseudonimizzato; la cassaforte si apre solo su richiesta esplicita, per abbinare identità o produrre un risultato nominativo richiesto, che resta sulla postazione.
-
Esportazioni per i collaboratori: cifre e tabelle aggregate, mai dati individuali.
-
Una checklist per ogni nuova fonte: come identifica un paziente (numero di inclusione il cui prefisso codifica il centro, codice di iniziali, codice opaco, numero semplice; un valore collettivo non diventa mai un paziente), quali fogli sono dizionari o tabelle trasposte (fonti di falsi pazienti), e un’architettura a due livelli: prima l’inclusione, poi l’arricchimento, che non aggiunge mai un paziente (verificato a ogni importazione). Si riparte dallo script della coorte più simile.
Per saperne di più
- Un controllo qualità senza falsi allarmi: intervalli fisiologici scritti; unità miste sospettate solo con almeno due file sorgente e un raggruppamento netto per un fattore 10; mai un allarme su un identificativo né un controllo di intervallo su una variabile 0/1; una convenzione di segno che cambia a seconda dell’anno ricondotta al valore assoluto.
- I dati ricavati dal referto: un valore assente dalla tabella si cerca nel referto, che fa fede; la negazione vale solo per la riga; un’indicazione all’esame non è una diagnosi; si conserva l’estratto giustificativo e si etichetta l’origine (tabella, referto, qualitativo, assente).
- Ogni elenco di pazienti avvia un’interrogazione longitudinale: abbinamento su almeno due elementi di identità; per persona, numero di esami, prima e ultima data, durata del follow-up; tre file in uscita (nominativo sulla postazione, pseudonimizzato, conteggi aggregati per la conversazione). Chi manca dall’indice attende in un modulo apposito (abbinato, nuovo, dubbio), fuso alla versione successiva.
- Una sentinella settimanale in sola lettura: integrità, record orfani, doppioni, intervalli, completezza per anno, file nuovi, modificati o cifrati; esito OK, allerta o errore, confrontato con quello della settimana precedente.
- Schede e caso collegati: Abbinare i pazienti senza fonderli per errore, Preparare l’inserimento dati in un registro, Costruire un database di ricerca con Claude.
Risultato
Un database versionato e documentato, e una risposta in pochi minuti alla domanda «quanti pazienti per questo studio?».
Salvaguardie
Prima le autorizzazioni: base giuridica, parere favorevole del responsabile della protezione dei dati e dell’ufficio per la ricerca clinica, luogo in cui il trattamento con l’IA è autorizzato, e chi decide i congelamenti. Dati sanitari: il quadro normativo applicabile alla ricerca (dichiarazione, metodologia di riferimento, informazione dei pazienti), archiviazione autorizzata dall’istituzione, nessun dato identificativo in un servizio non autorizzato. Consultare l’ufficio per la ricerca clinica e il DPO (responsabile della protezione dei dati) della propria istituzione.
Prompt di partenza
Ecco l’elenco (solo i nomi delle colonne, nessun dato) dei miei 4 file di coorte. Proponi un dizionario dei dati armonizzato, regole di controllo qualità e la struttura delle cartelle della pipeline. Non aprire alcun dato dei pazienti.