Investigación
Organizar una base de datos de investigación
Del archivo en bruto a la base versionada: conjuntos de datos básicos por patología, un índice seudonimizado, controles de calidad y una página de consulta que solo muestra agregados.
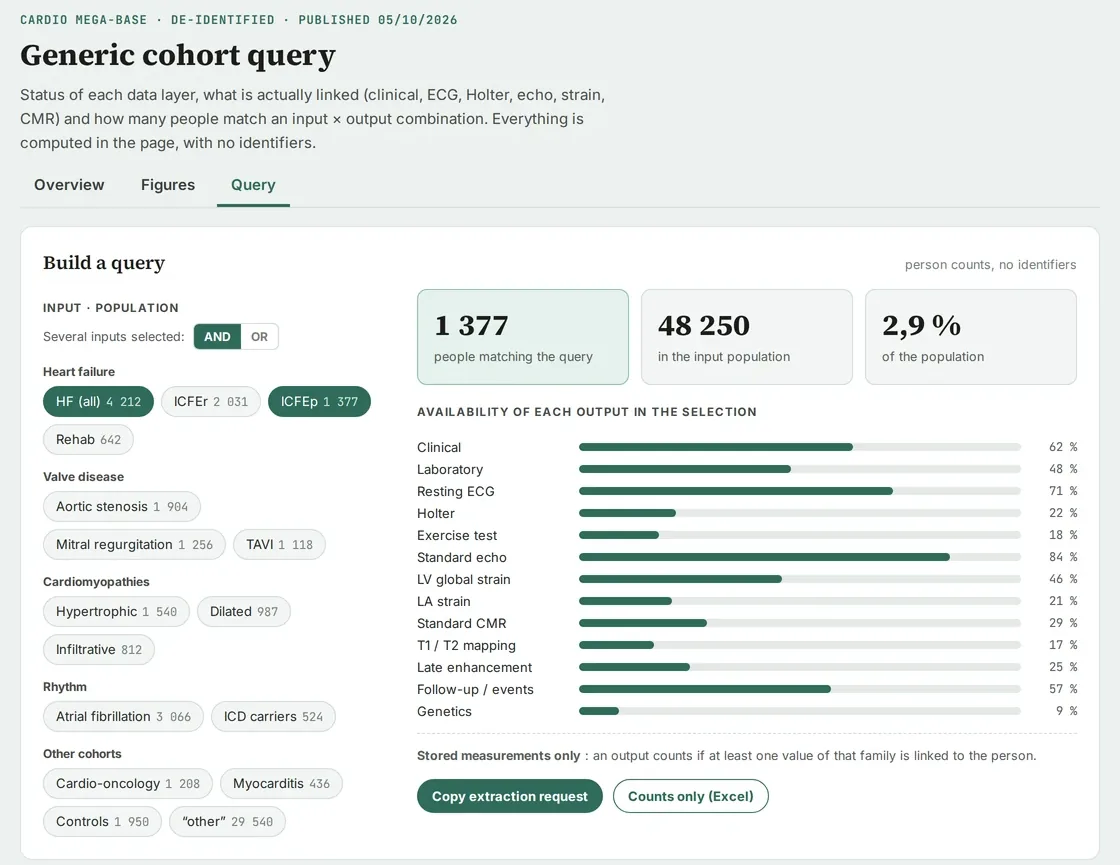
Captura de una herramienta real · datos ficticios, nombres difuminados · interfaz en inglés
El problema
Años de hojas de cálculo de cohortes, exportaciones de pruebas y recogidas de datos de tesis, cada una con su propio formato. La pregunta «¿cuántos pacientes tenemos con este fenotipo y este dato?» lleva una semana.
Método paso a paso
-
Un circuito escrito: original → bruto → armonizado → base → análisis → exportación, cada etapa en su propia carpeta; nada se modifica sobre el propio archivo. La base se copia en local y nunca se abre en una carpeta de red; los procesos largos pueden reanudarse, cada escritura se hace en modo todo o nada con recuento, y una versión se publica mediante copia verificada y después sustitución, archivando la anterior.
-
Conjuntos de datos básicos por patología, cada uno con su versión (candidata, congelada) y un procedimiento de congelación. La congelación sigue cinco pasos: un cuaderno de variables precumplimentado (tipo deducido, tasa de cumplimentación real) validado por el responsable, la importación, un informe de calidad en cinco familias (identidad, duplicados, rangos, coherencia, completitud), la resolución de las discrepancias en bloque y, por último, una congelación numerada y fechada con su copia fija. Una variable sin decisión no se conserva; una corrección de fondo abre una nueva versión y repite los cinco pasos.
-
Un índice pivote seudonimizado para eliminar duplicados de pacientes presentes en varias cohortes, conservado en el puesto de trabajo local. El cruce entre fuentes se basa en una puntuación, nunca en un solo parámetro: véase Cruzar pacientes sin fusionarlos por error.
-
Reglas de control de calidad y un registro de decisiones (por qué se recodificó una variable). Los datos se mantienen en formato largo, con cada valor trazado hasta su celda de origen (archivo, hoja, fila, columna). Un valor no válido, una unidad dudosa o un conflicto entre fuentes se conserva y se etiqueta; en la congelación se elige un único valor de referencia. NULL no es cero, y toda exclusión es motivada y reversible.
-
Distinguir «medida en la base» de «archivo disponible»: se sabe qué es realmente utilizable. Se publican tres niveles de cifras: personas censadas, personas con un archivo fuente y personas con medidas en la base, además de la completitud máxima de una medida cruzando todos los archivos. Una auditoría de cobertura, año por año, distingue un hueco de la fuente (pruebas solo fechadas, confirmadas por una reexportación idéntica) de un fallo de enlace, con un recuento independiente.
-
Una página de consulta que solo maneja agregados: población, criterios, datos necesarios, resultado en recuentos. Cada panel estadístico lleva un recuadro «limitaciones»: fenotipo definido por niveles, pareja de dos pruebas formada dentro de una ventana temporal y solo con enlaces fiables, mediana [Q1–Q3] con el número de medidas, y todo recuento por debajo del umbral acordado mostrado como «menos de N».
-
La extracción identificable se hace en local, mediante un script, a partir de una «solicitud de extracción» validada. La solicitud genera un libro normalizado (pestañas LEEME, PACIENTES, una por familia de datos, DICCIONARIO, FUENTES), seudonimizado por defecto; el botón «solo recuentos» suele bastar. Cada consulta queda registrada (fecha, especificación) para poder repetirla de forma idéntica.
-
Un «cajón cerrado» para los datos sensibles: lo que nunca debe entrar en herramientas de IA se aísla y se documenta, y las dudas sobre su acceso se resuelven con la institución. En la práctica, dos copias: la base de trabajo seudonimizada (identificadores aleatorios, solo el año de nacimiento, texto libre depurado, equivalencia con el original demostrada, versión numerada) y la caja fuerte (clave de correspondencia y originales). La IA solo trabaja con la base seudonimizada; la caja fuerte solo se abre a petición expresa, para cruzar identidades o elaborar un entregable nominativo solicitado, que se queda en el puesto de trabajo.
-
Exportaciones para colaboradores: cifras y tablas agregadas, nunca datos individuales.
-
Una lista de comprobación para cada fuente nueva: cómo identifica a un paciente (número de inclusión cuyo prefijo codifica el centro, código de iniciales, código opaco, número solo; un valor colectivo nunca se convierte en paciente), qué hojas son diccionarios o tablas traspuestas (origen de falsos pacientes), y una arquitectura en dos niveles: primero la inclusión, después el enriquecimiento, que nunca añade pacientes (se comprueba en cada importación). Se parte del script de la cohorte más parecida.
Para ir más lejos
- Un control de calidad sin falsas alarmas: rangos fisiológicos por escrito; mezcla de unidades sospechada solo con al menos dos archivos fuente y una agrupación nítida por un factor 10; nunca una alerta sobre un identificador ni un control de rango sobre una variable 0/1; una convención de signo que cambia según el año se lleva al valor absoluto.
- Los datos extraídos del informe: un valor ausente de la tabla se busca en el informe, que es el que da fe; la negación se limita a la línea; una indicación de prueba no es un diagnóstico; se guarda el fragmento justificativo y se etiqueta el origen (tabla, informe, cualitativo, ausente).
- Toda lista de pacientes desencadena una consulta longitudinal: emparejamiento con al menos dos elementos de identidad; por persona, número de pruebas, primera y última fecha, duración del seguimiento; tres archivos de salida (nominativo en el puesto, seudonimizado, recuentos agregados para la conversación). Quienes faltan en el índice esperan en un módulo de espera (enlazado, nuevo, dudoso), fusionado en la versión siguiente.
- Un centinela semanal de solo lectura: integridad, huérfanos, duplicados, rangos, completitud por año, archivos nuevos, modificados o cifrados; veredicto OK, alerta o error, comparado con el de la semana anterior.
- Fichas y caso relacionados: Cruzar pacientes sin fusionarlos por error, Preparar la recogida de datos de un registro, Construir una base de investigación con Claude.
Entregable
Una base versionada y documentada, y una respuesta en minutos a «¿cuántos pacientes para este estudio?».
Salvaguardas
Primero las autorizaciones: base jurídica, visto bueno del delegado de protección de datos y de la unidad de investigación clínica, lugar donde se autoriza el tratamiento con IA, y quién decide las congelaciones. Datos de salud: el marco normativo aplicable a la investigación (declaración, metodología de referencia, información al paciente), almacenamiento autorizado por la institución, ningún dato identificativo en un servicio no autorizado. Consultar a la unidad de investigación clínica de la institución y al DPD (delegado de protección de datos).
Prompt de partida
Esta es la lista (solo nombres de columnas, sin datos) de mis 4 archivos de cohortes. Propón un diccionario de datos armonizado, reglas de control de calidad y la estructura de carpetas del circuito. No abras ningún dato de pacientes.